todo funciona hasta que te pones creativo con la indexación
En ThriveDesk movemos muchas conversaciones de clientes y usamos Meilisearch para que buscar en ellas sea rápido. Una tarde tranquila, en medio de un trabajo de reindexación, me lanzó esto:
Document doesn't have an `id` attributeTodos los documentos del lote tenían un id, así que un error de “document doesn't have an id attribute” no tenía sentido. Lo revisé dos veces. El error resultó ser totalmente culpa mía, y arreglarlo implicó renunciar a una de las comodidades de Laravel Scout y hablar directamente con Meilisearch. Esto es lo que pasó.
¿Por qué no usar simplemente Laravel Scout?
Scout es el camino fácil cuando lo único que quieres es “mantener este modelo sincronizado con el índice”: marcas el modelo como searchable y te olvidas. El problema es que Scout oculta lo que nos importa cuando sube el volumen: el ID de tarea.
Toda operación asíncrona en Meilisearch, como agregar o eliminar documentos, devuelve un taskUid. Puedes consultar ese ID para saber si el trabajo realmente se completó. Scout no lo expone. Cuando envías miles de conversaciones por un flujo de procesamiento, “llamé a searchable(), así que probablemente funcionó” no es una estrategia de monitoreo. Queríamos registrar cada tarea encolada, reintentar las que fallaran y comprobar el estado real del índice.
Por eso omitimos el helper de Scout y llamamos nosotros mismos a addDocuments() y deleteDocuments() de Meilisearch a través del motor subyacente, y luego tomamos el taskUid y lo guardamos.
El error real: un arreglo disperso
Estaba agrupando conversaciones en lotes para indexarlas, y algunas estaban duplicadas, así que eliminé los duplicados con ->unique(). El resultado se veía así:
$filtered = collect([
    0 => ['id' => 1],
    1 => ['id' => 2],
    3 => ['id' => 4], // index 2 is gone
]);
Cada elemento sigue teniendo un id, así que a simple vista parece correcto. Pero mira las claves: 0, 1, 3. Cuando unique() eliminó el duplicado en el índice 2, conservó las claves originales y dejó un hueco. El arreglo ahora es disperso, y ese hueco es todo el problema. La causa de que falle es PHP, no Meilisearch.
Cuando json_encode() recibe un arreglo cuyas claves enteras van 0, 1, 2, … sin huecos, produce un arreglo JSON:
[{"id":1},{"id":2},{"id":4}]Si pones un hueco en esas claves, PHP ya no puede tratarlo como una lista, y en su lugar lo codifica como un objeto JSON:
{"0":{"id":1},"1":{"id":2},"3":{"id":4}}addDocuments() espera un arreglo de documentos. Si le das un objeto, lee toda la carga como un único documento, cuyos campos de nivel superior son “0”, “1” y “3”. Ese único document no tiene un campo id, así que el error decía la verdad literal. Le había entregado la forma equivocada.
La solución
->values() descarta las claves y las renumera desde cero, lo cual basta para volver a obtener un arreglo JSON:
$task = $engine->index($this->index)->addDocuments(
    $uniqueSearchableDocuments->filter()->values()->all(),
    (new Conversation)->getKeyName()
);
Lo mismo en la ruta de eliminación:
$task = $engine->getIndex($this->index)->deleteDocuments(
    $shouldMakeUnsearchable->values()->all()
);
El segundo argumento de addDocuments() es el nombre de la clave primaria. Lo leemos del modelo con getKeyName() en lugar de escribir id a mano, para que siga funcionando si eso cambia algún día.
Las conclusiones principales
filter() y unique() conservan las claves originales de la colección. Es deliberado, y dentro de Laravel suele ser lo que quieres. Deja de serlo en cuanto los datos salen de PHP hacia una API externa, así que acostúmbrate a llamar a ->values() después de cualquiera de las dos cuando vayas a serializar.
También es un buen recordatorio de que errores como este viven en la frontera entre sistemas. Parecía un problema de Meilisearch hasta que miré el JSON real, y entonces quedó claro que era un problema de serialización que yo mismo había causado.
Y si de verdad necesitas saber si tu indexación funcionó, searchable() no te lo dirá. Llamar directamente a los métodos de Meilisearch requiere más código, pero es la única forma de obtener el taskUid y construir reintentos sobre él.
Cómo funciona el flujo en producción
Una fila BatchTask controla cada lote. Las tareas de tipo searchable cargan las conversaciones, eliminan los duplicados, reinician las claves con values(), llaman a addDocuments() y guardan el taskUid devuelto. Las tareas de tipo unsearchable cargan los objetivos, reinician las claves, llaman a deleteDocuments() y guardan el taskUid de la misma manera. El diagrama de abajo muestra ambas rutas.
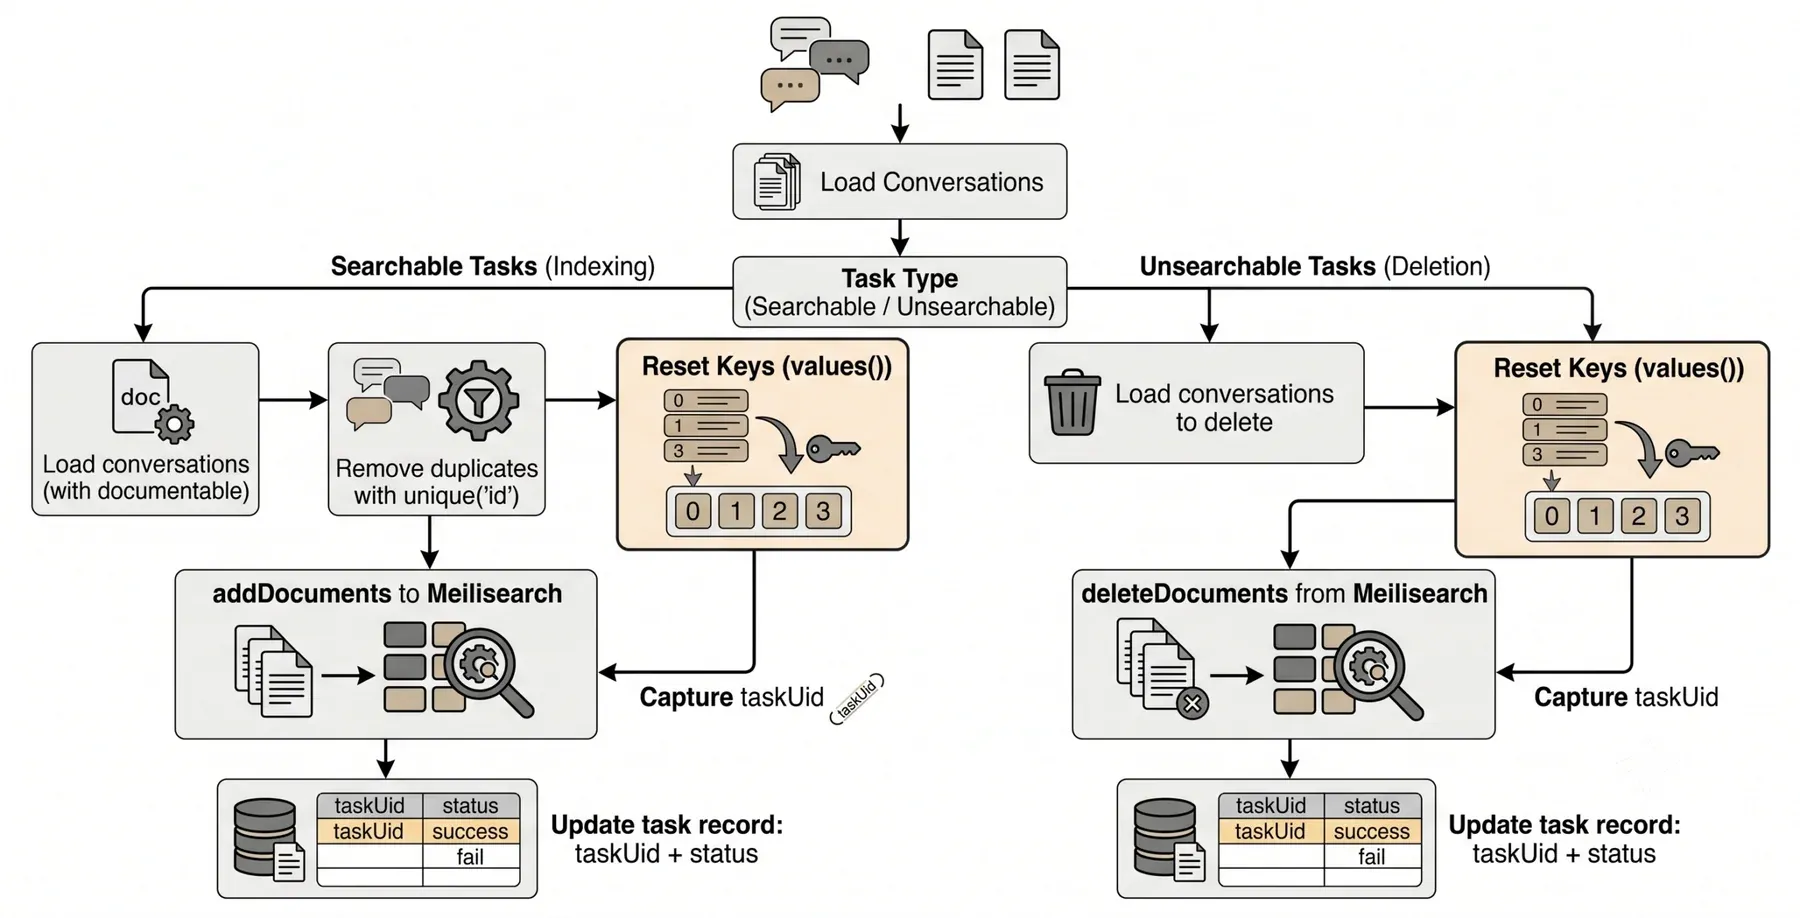
Rastrear el taskUid por lote ha valido la pena. Podemos saber si un lote tuvo éxito o falló en lugar de asumir que funcionó. Las tareas fallidas se reintentan con un contador de intentos, y la corrección con values() también eliminó un montón de errores falsos positivos que añadían ruido a nuestros registros.
Reflexión final
La infraestructura de búsqueda parece simple hasta que la ejecutas a escala, y entonces los pequeños supuestos son los que te atrapan. Esta fue una colección de Laravel que parecía JSON válido y no lo era, en el momento en que cruzó hacia Meilisearch.
Así que, si te llevas una sola cosa de aquí: después de filtrar o eliminar duplicados en una colección que va hacia un sistema externo, llama a ->values(). Es barato y te ahorrará una tarde.
En ThriveDesk hacemos bastante de esto: procesamiento por lotes, seguimiento de tareas asíncronas y embeddings para búsqueda semántica. Si estás conectando Laravel y Meilisearch y quieres comparar notas, escríbenos.